Новость
CoreWeave запускает облачные мощности на базе Nvidia Vera Rubin NVL72
По данным Network World, CoreWeave открыл в облаке доступ к платформе Nvidia Vera Rubin NVL72 и одновременно представил среду разработки Forge.
Эрнест Литвиненко·обновлено 02 октября 2026 г.
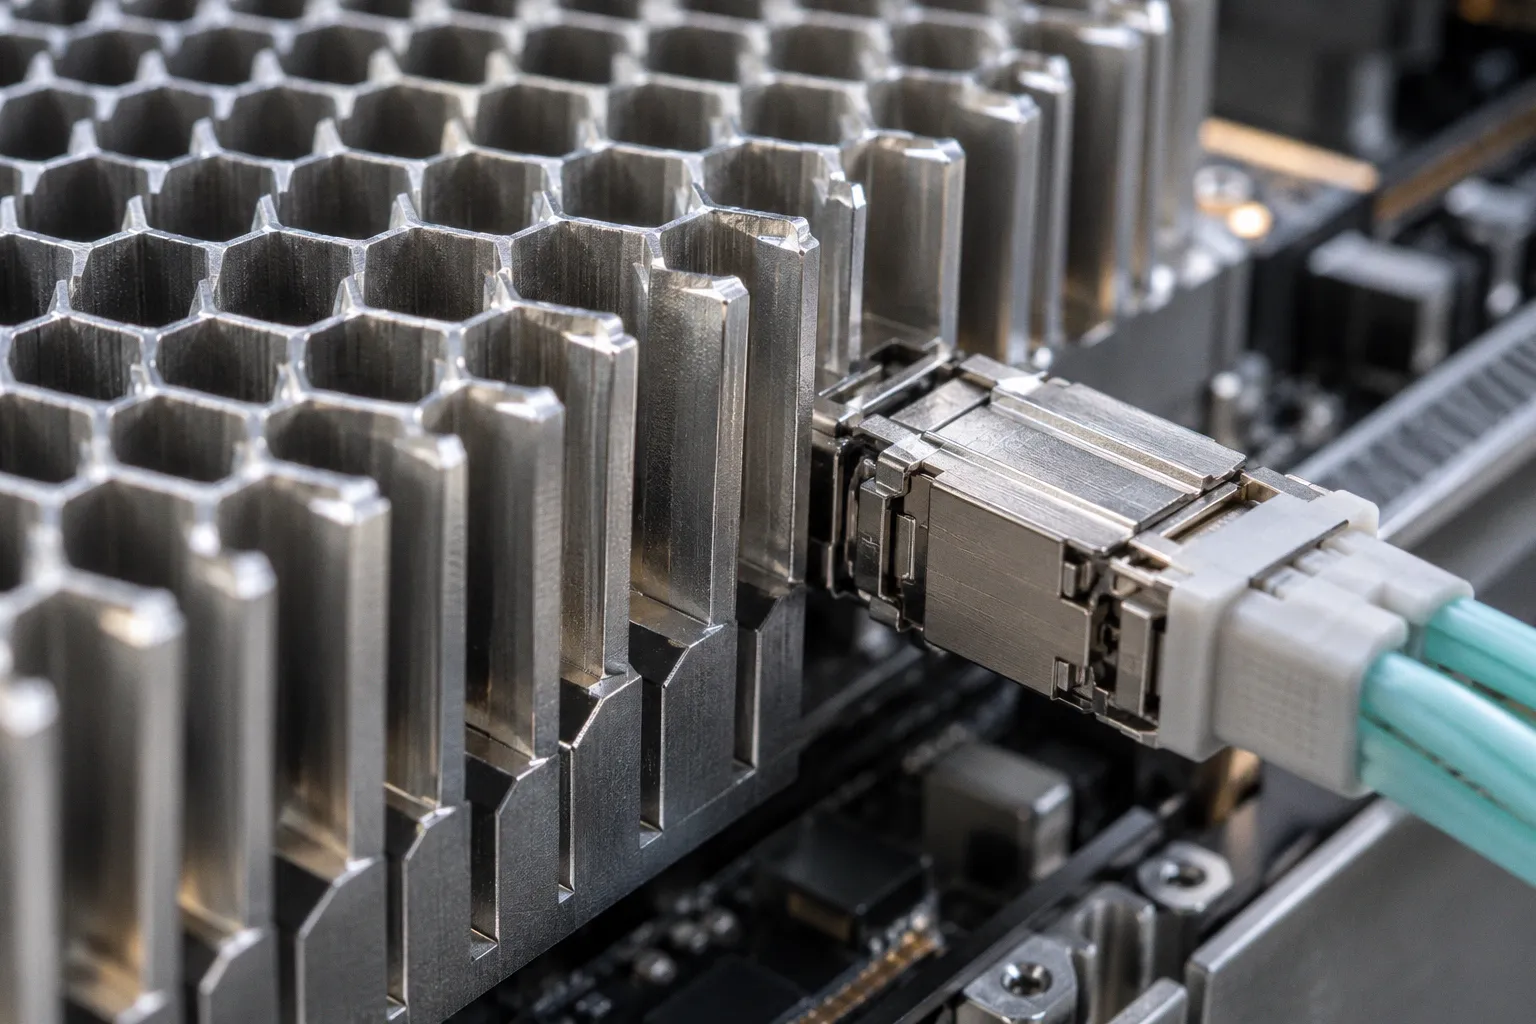
CoreWeave выводит Vera Rubin NVL72 в облако
Первым коммерческим заказчиком выступила Cognition, разработчик агента Devin, которая уже провела на новом железе inference-бенчмарк. Для архитектурного комитета это сигнал о новом цикле rack-scale AI: меняется baseline по пропускной способности, появляется выделенный CPU-слой и консолидируется dev-конвейер.
Метрики Vera Rubin в продакшне Cognition
- Cognition развернула Vera Rubin-кластер в начале сентября 2026 и выполнила на нём бенчмарк, который CoreWeave характеризует как первый customer-executed на платформе.
- Зафиксирован рост общей token throughput до 4,8X для SWE-2 inference относительно GB200 NVL72.
- Для RL-нагрузок заявлен прирост output-token throughput 3,8X.
- Вице-президент CoreWeave по продукту и разработке Чен Голдберг связывает эффект с давлением длинных контекстов, повторных вызовов модели и тысяч параллельных задач на платформу.
- Ожидаемые следствия для Devin: больше параллельных сессий на GPU, ниже cost-per-session, сохранение latency.
Архитектура стенда: Vera CPU и сетевой слой
- CoreWeave добавил поддержку Vera CPU как ответ на рост CPU-интенсивной работы вокруг agentic-нагрузок: изолированные среды исполнения, tool calls, code execution, data pipelines.
- Базовая конфигурация стойки: 128 Vera CPU, 11 264 CPU-ядра суммарно.
- В стойку входят Nvidia BlueField-4 DPU и Spectrum-X Ethernet switching для связности Vera-нод.
- Заявленная ёмкость: более 11 000 параллельных agent-окружений на стойку.
- Развёрнутые ранее GB200 и GB300 NVL72, включая Dell PowerRack-конфигурации, остаются в эксплуатации. Заявлена совместимость tooling и operational playbook между поколениями.
Forge и что отслеживать
- Forge объединяет experiment tracking, evaluation, agent observability, post-training, inference и model management в одной среде.
- Цель: замкнуть цикл production → training → следующая итерация модели без переключения между вендорами.
- Риск: проприетарный слой CoreWeave плюс Nvidia усиливает vendor lock-in и сужает пространство для альтернативного inference-стека.
- Что валидировать перед миграцией: реальные пайплайны на GB200/GB300, географию развёртывания Vera Rubin, прозрачность ценообразования per-session.
Эффект подобных анонсов проявляется и в прикладных слоях цифровых сервисов, в частности в обновлениях мобильных приложений Центральной Евразии за сентябрь 2026.